Redis集群
AKF原则:水平、服务拆分、数据分片
Redis复制(Master/Slave)
Redis的复制,也就是我们所说的主从复制,主机数据更新后根据配置和策略,自动同步到备机的master/slaver机制,Master以写为主,Slave以读为主的策略。主要用来读写分离和容灾恢复。
配从(库)不配主(库),配置主从复制,只需要把从库指向一个主库,实现对主库的复制即可,不需要主库做任何操作。
可以通过命令配置达到效果,但是每次与master断开之后,都需要重新执行命令连接,除非配置进redis.conf文件,新版本的slaveof改名成replicaof。
1 | slaveof 主库IP 主库端口 |
建议配置时拷贝多个redis.conf文件,通过redis-server启动时指定启动的配置文件即可。配置文件需要修改相应的配置:
- 开启守护线程后台运行
- 修改
PID文件名称 - 修改指定端口
- 修改
Log文件名称 - 修改
dump.rdb名称
1 | #redis.conf配置 |
一主二仆
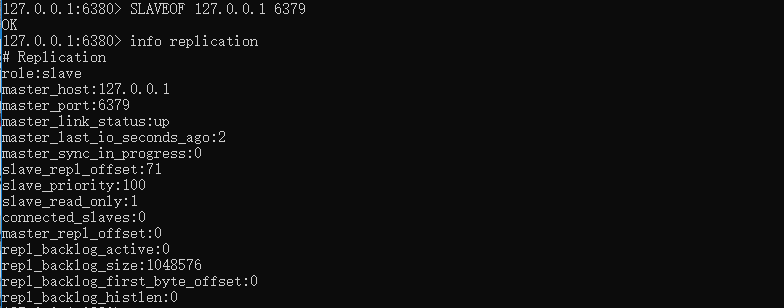
可以看到从库(6380端口)配置了主库(6379端口)后,能够看到他的role标识为slave。
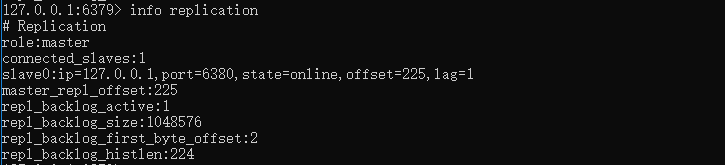
可以看到主库的role标识为master,其中connected_slaves连接的salve是1个。
当有多个slave时,他们配置的master都是同一个,即所有salve都直接和master进行数据同步策略。
薪火相传
上一个slave可以是下一个slave的master,slave同样可以接收其他slaves的连接和同步请求,那么该slave作为了链条中下一个的master,可以有效减轻master的写压力。
就好比如slave1(6380端口)配置了主库master(6379),然后salve2(6381端口)配置了slave1做master,那么当6379端口的主库修改了数据时,会先同步到slave1,然后再由slave1同步到slave2。
中途变更转向:会清除之前的数据,重新建立拷贝最新的。
反客为主
当主库master故障时,从库slave是不会自动上位成master,将依旧保持slave从库,这并不是我们想要的结果,可以通过手动将从库转换成主库,并修改其他从库的master配置,使当前数据库停止与其他数据库的同步,转成主数据库
1 | SLAVEOF no one |
复制原理
slave启动成功连接到master后会发送一个sync命令,master接到命令启动后台的存盘进程,同时收集所有接收到的用于修改数据集命令,在后台进程执行完毕之后,master将传送整个数据文件到slave,以完成一次完全同步。
全量复制:而slave服务在接收到数据库文件数据后,将其存盘并加载到内存中。
增量复制:master继续将新的所有收集到的修改命令依次传给slave,完成增量同步。
但是只要是重新连接master,一次完全同步(全量复制)将被自动执行
哨兵模式
哨兵模式是反客为主的自动版,能够后台监控主机是否故障,如果故障了根据投票数自动将从库转换为主库
通过创建sentinel.conf配置文件,并新增监控机器的配置,一组sentinel能同时监控多个Master。
1 | # sentinel monitor 自定义的名称 127.0.0.1 6379 1 |
1 | linux系统执行命令 |
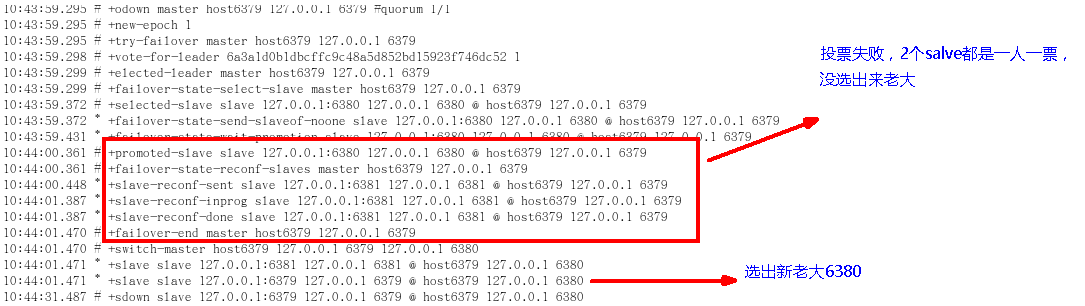
通过执行启动哨兵,当master节点挂了后,哨兵模式会自动从salve中投票选举出新的master,原来的master节点重新加入时,将会变成salve节点。哨兵模式最低限度能够达到仅剩一台slave时,将之升级为master,即支持当master机器没有slave节点时,依旧能够正常工作。
由于所有的写操作都是先在master上操作,然后同步更新到slave上,所以从master同步到slave机器有一定的延迟,当系统很繁忙的时候,延迟问题会更加严重,slave机器数量的增加也会使这个问题更加严重。
代理
twemproxy
官方文档 代理多个Redis进行分片数据分发。
1 | [root@localhost twemproxy]# wget https://github.com/twitter/twemproxy/archive/master.zip |
1 | #设置使用全局命令nutcracker |
1 | #修改配置文件 |
1 | #如果执行 autoreconf -fvi 提示版本过低,则执行以下命令 |
predixy
三台哨兵做集群,监控两个主从Redis,自动将两个主从进行分组,数据分而治之到不同的Master中。
1 | [root@localhost predixy]# wget https://github.com/joyieldInc/predixy/releases/download/1.0.5/predixy-1.0.5-bin-amd64-linux.tar.gz |
1 | #redis的哨兵模式配置文件sentinel-26379.conf 监控两个主从的redis |
1 | #redis的哨兵模式配置文件sentinel-26380.conf 监控两个主从的redis |
1 | #redis的哨兵模式配置文件sentinel-26381.conf 监控两个主从的redis |
1 | #进入bin目录 |
Redis-Cluster
自从redis 3.0版本开始支持redis-cluster集群,redis-cluster采用无中心结构,每个节点保存数据和整个集群的状态,每个节点都和其他所有节点连接。
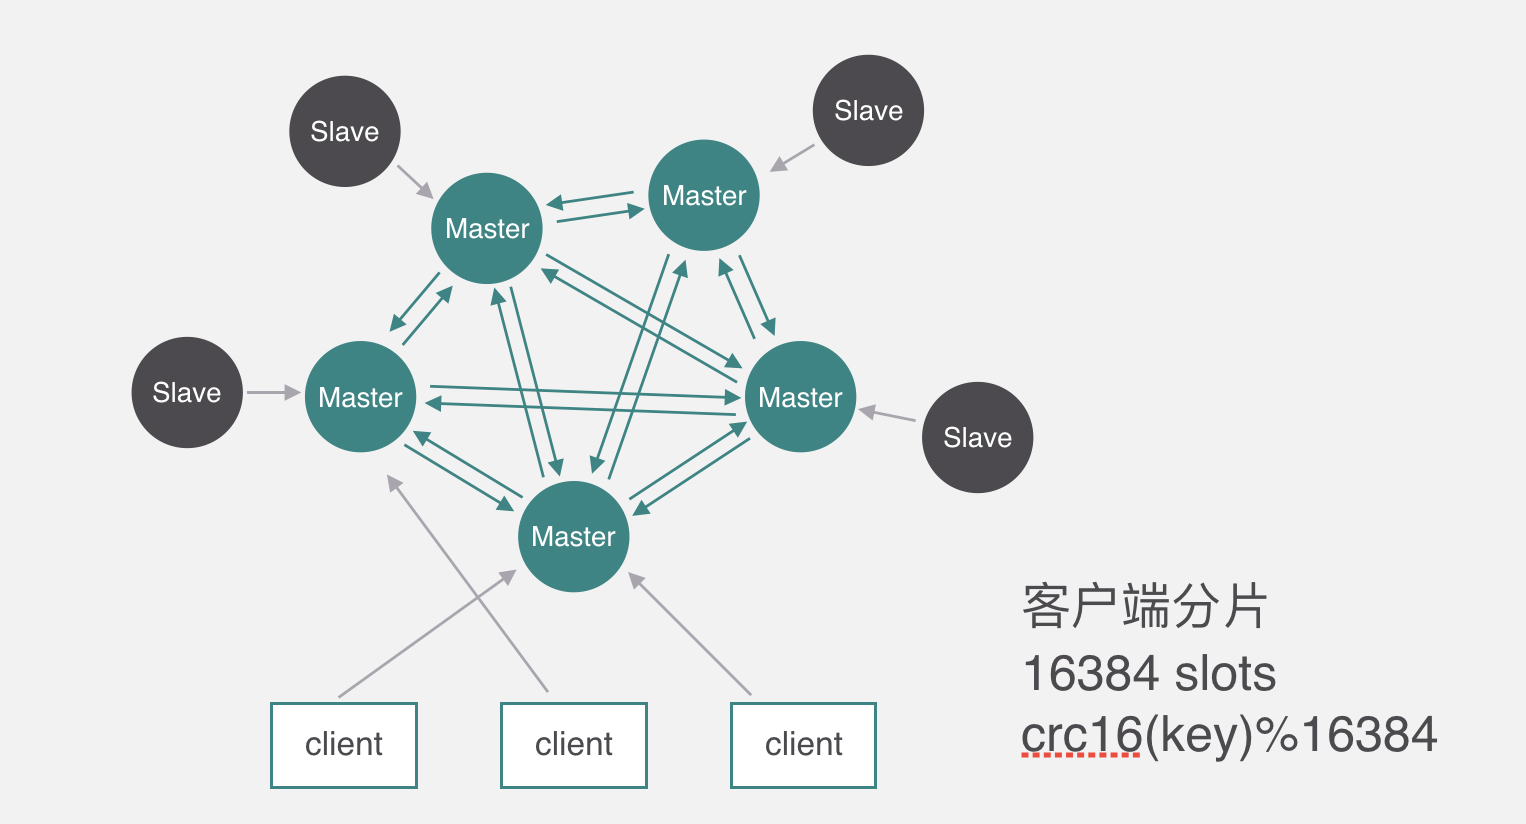
无需proxy代理,客户端直接与redis集群的每个节点连接,根据同样的hash算法计算出key对应的slot,然后直接在slot对应的redis节点上执行命令。
在redis看来,响应时间是最苛刻的条件,增加一层带来的开销是redis不能接受的。因此,redis实现了客户端对节点的直接访问,为了去中心化,节点之间通过gossip协议交换互相的状态,以及探测新加入的节点信息。redis集群支持动态加入节点,动态迁移slot,以及自动故障转移。
数据分片
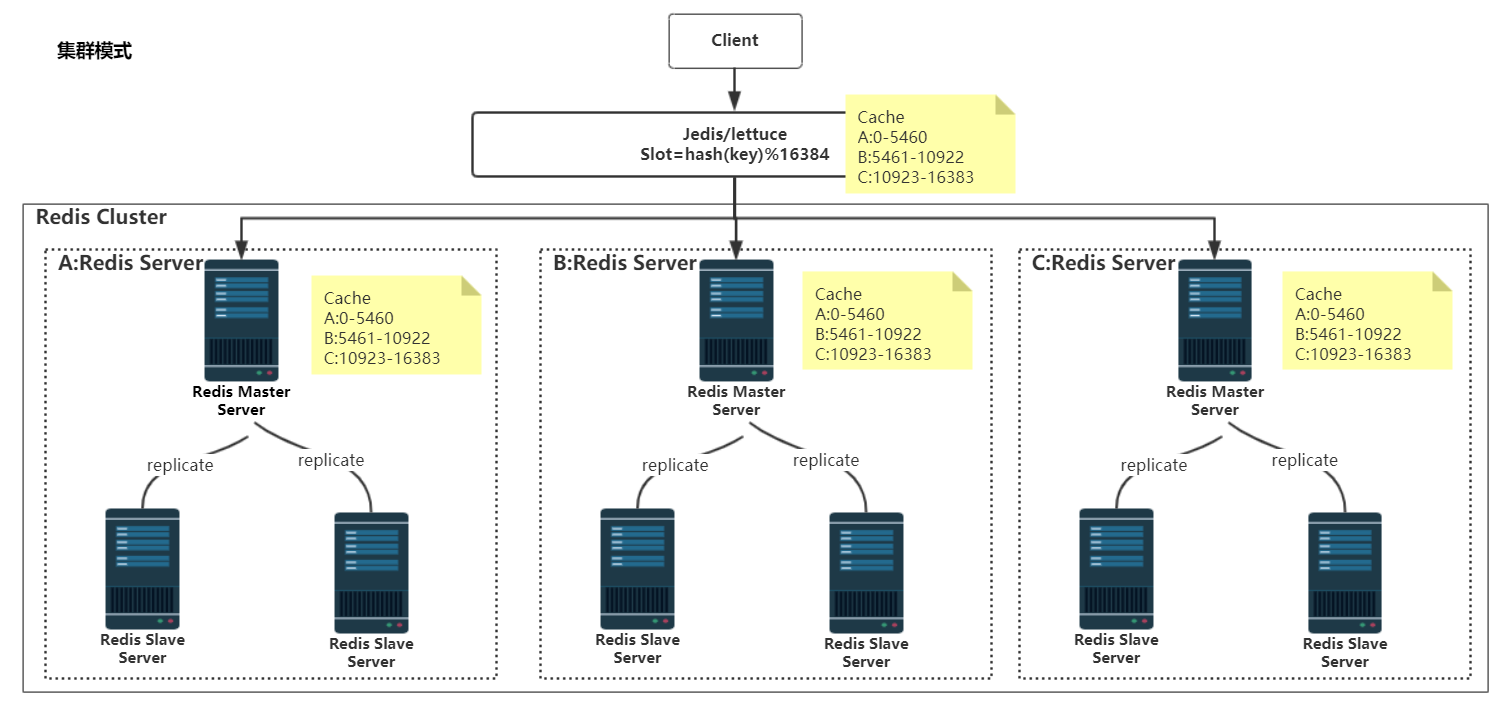
redis 集群使用数据分片(sharding)而非一致性哈希(consistency hashing)来实现,Redis Cluster 采用的是虚拟槽分区算法,这个槽是用来存放缓存信息的单位,一个redis 集群包含 16384 个哈希槽(hash slot),槽的范围是 0 -16383,数据库中的每个键都属于这 16384 个哈希槽的其中一个。
集群使用公式 CRC16(key) % 16384 来计算键key属于哪个槽, 其中 CRC16(key) 语句用于计算键 key 的 CRC16 校验和 。集群中的每个节点负责处理一部分哈希槽。
举个例子, 一个集群可以有三个节点, 其中:
- 节点 A 负责处理 0 号至 5500 号哈希槽。
- 节点 B 负责处理 5501 号至 11000 号哈希槽。
- 节点 C 负责处理 11001 号至 16383 号哈希槽。
此时 Redis Client 需要根据一个Key获取对应的 Value 的数据,首先通过 CRC16(key)%16384 计算出 Slot 的值,假设计算的结果是 5000,将这个数据传送给 Redis Cluster,集群接收到以后会到一个对照表中查找这个 Slot=5000 属于那个缓存节点。发现属于“节点 A ”负责,于是顺着红线的方向调用节点 A中存放的 Key-Value 的内容并且返回给 Redis Client。
这种将哈希槽分布到不同节点的做法使得用户可以很容易地向集群中添加或者删除节点。 比如说:
- 如果用户将新节点 D 添加到集群中, 那么集群只需要将节点 A 、B 、 C 中的某些槽移动到节点 D 就可以了。
- 如果用户要从集群中移除节点 A , 那么集群只需要将节点 A 中的所有哈希槽移动到节点 B 和节点 C , 然后再移除空白(不包含任何哈希槽)的节点 A 就可以了。
因为将一个哈希槽从一个节点移动到另一个节点不会造成节点阻塞,且成本很低, 所以无论是添加新节点还是移除已存在节点, 又或者改变某个节点包含的哈希槽数量, 都不会造成集群下线。
数据访问
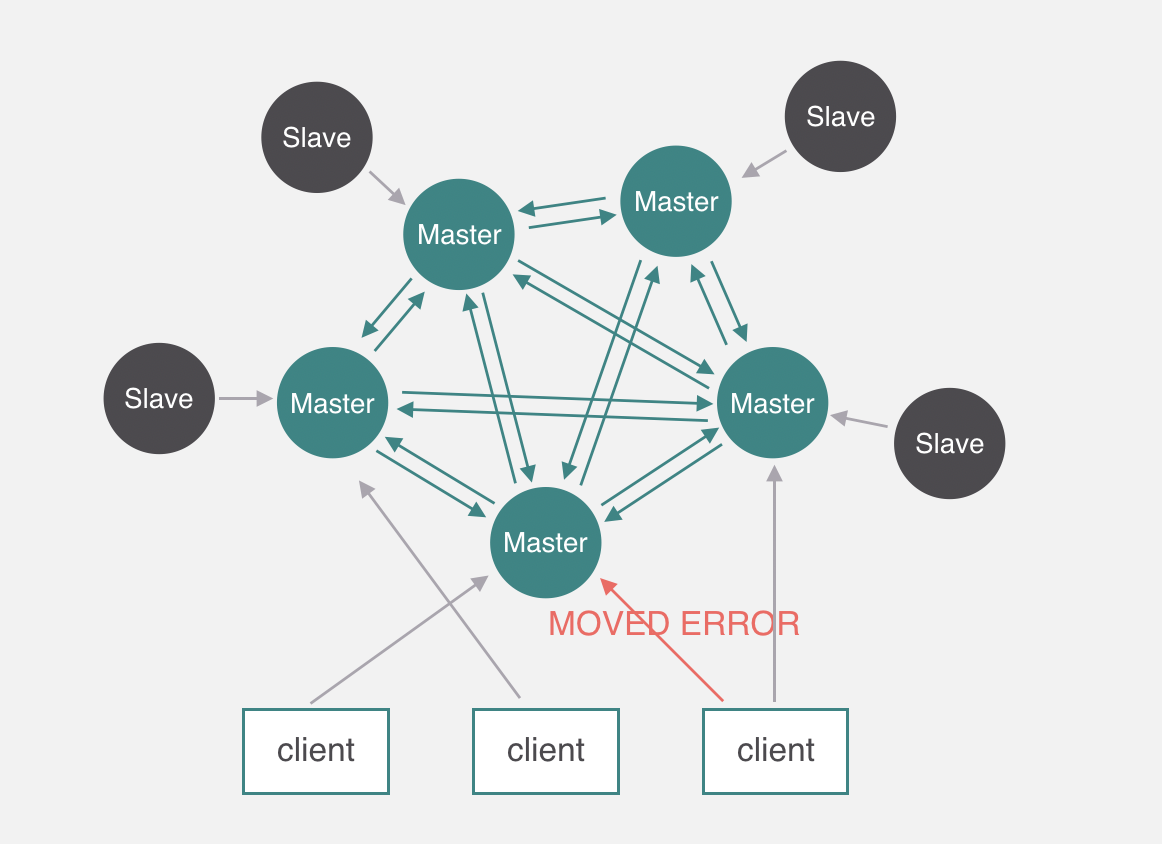
客户端在初始化的时候只需要知道一个节点的地址即可,客户端会先尝试向这个节点执行命令,比如“get key”,如果key所在的slot刚好在该节点上,则能够直接执行成功。如果slot不在该节点,则节点会返回MOVED错误,同时把该slot对应的节点告诉客户端。客户端可以去该节点执行命令。
集群支持hash tags功能,即可以把一类key定位到同一个slot,tag的标识目前不支持配置,只能使用{},redis处理hash tag的逻辑也很简单,redis只计算从第一次出现{,到第一次出现}的substring的hash值,substring为空,则仍然计算整个key的值,也能取出tag值。
1 | 127.0.0.1:6379> set {oo}k2 aaa |
我们都知道,redis单机支持mutl-key操作(mget、mset)。redis cluster对mutl-key命令的支持,只能支持多key都在同一个slot上,即使多个slot在同一个节点上也不行。通过hash tag可以很好的做到这一点。
数据结构
Redis Cluster中的每个节点都保存了集群的配置信息,并且存储在clusterState中,结构如下:
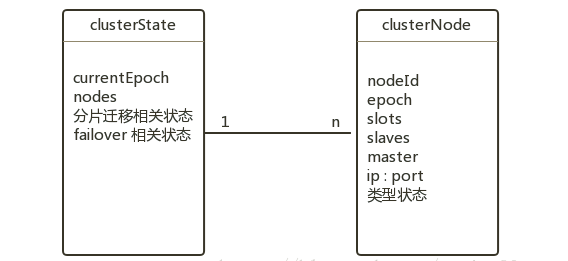
上图的各个变量语义如下:
clusterState记录了从集群中某个节点视角,来看集群配置状态;currentEpoch表示整个集群中最大的版本号,集群信息每变更一次,改版本号都会自增。nodes是一个列表,包含了本节点所感知的,集群所有节点的信息(clusterNode),也包含自身的信息。clusterNode记录了每个节点的信息,其中包含了节点本身的版本Epoch;自身的信息描述:节点对应的数据分片范围(slot)、为master时的slave列表、为slave时的master等。
每个节点包含一个全局唯一的NodeId。
当集群的数据分片信息发生变更(数据在节点间迁移时),Redis Cluster仍然保持对外服务。
当集群中某个master出现宕机时,Redis Cluster 会自动发现,并触发故障转移的操作。会将master的某个slave晋升为新的 master。
由此可见,每个节点都保存着Node视角的集群结构。它描述了数据的分片方式,节点主备关系,并通过Epoch作为版本号实现集群结构信息的一致性,同时也控制着数据迁移和故障转移的过程。
节点通信
在Redis Cluster中,这个配置信息交互通过Redis Cluster Bus来完成(独立端口)。Redis Cluster Bus上交互的信息结构如下:
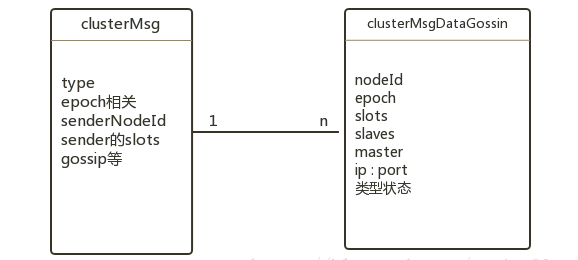
clusterMsg 中的type指明了消息的类型,配置信息的一致性主要依靠PING/PONG。每个节点向其他节点频繁的周期性的发送PING/PONG消息。对于消息体中的Gossip部分,包含了sender/receiver 所感知的其他节点信息,接受者根据这些Gossip 跟新对集群的认识。
对于大规模的集群,如果每次PING/PONG 都携带着所有节点的信息,则网络开销会很大。此时Redis Cluster 在每次PING/PONG,只包含了随机的一部分节点信息。由于交互比较频繁,短时间的几次交互之后,集群的状态也会达成一致。
一致性
当Cluster 结构不发生变化时,各个节点通过gossip 协议在几轮交互之后,便可以得知Cluster的结构信息,达到一致性的状态。但是当集群结构发生变化时(故障转移/分片迁移等),优先得知变更的节点通过Epoch变量,将自己的最新信息扩散到Cluster,并最终达到一致。
clusterNode 的Epoch描述的单个节点的信息版本;clusterState 的currentEpoch 描述的是集群信息的版本,它可以辅助Epoch 的自增生成。因为currentEpoch 是维护在每个节点上的,在集群结构发生变更时,Cluster 在一定的时间窗口控制更新规则,来保证每个节点的currentEpoch都是最新的。
更新规则如下:
当某个节点率先知道了变更时,将自身的currentEpoch 自增,并使之成为集群中的最大值。再用自增后的currentEpoch 作为新的Epoch 版本;
- 当某个节点收到了比自己大的
currentEpoch时,更新自己的currentEpoch; - 当收到的
Redis Cluster Bus消息中的某个节点的Epoch> 自身的时,将更新自身的内容; - 当
Redis Cluster Bus消息中,包含了自己没有的节点时,将其加入到自身的配置中。
上述的规则保证了信息的更新都是单向的,最终朝着Epoch更大的信息收敛。同时Epoch也随着currentEpoch的增加而增加,最终将各节点信息趋于稳定。
为了使得集群在一部分节点下线或者无法与集群的大多数(majority)节点进行通讯的情况下, 仍然可以正常运作, Redis 集群对节点使用了主从复制功能: 集群中的每个节点都有 1 个至 N 个复制品(replica), 其中一个复制品为主节点(master), 而其余的 N-1 个复制品为从节点(slave)。
集群间节点支持主从关系,复制的逻辑基本复用了单机版的实现。不过还是有些地方需要注意。
- 首先集群间节点建立主从关系不再使用原有的
SLAVEOF命令和SLAVEOF配置,而是通过cluster replicate命令,这保证了主从节点需要先完成握手,才能建立主从关系。 - 集群是不能组成链式主从关系的,也就是说从节点不能有自己的从节点。不过对于集群外的没开启集群功能的节点,
redis并不干预这些节点去复制集群内的节点,但是在集群故障转移时,这些集群外的节点,集群不会处理。 - 集群内节点想要复制另一个节点,需要保证本节点不再负责任何
slot,不然redis也是不允许的。 - 集群内的从节点在与其他节点通信的时候,传递的消息中数据分布表和
epoch是master的值。
集群主节点出现故障,发生故障转移,其他主节点会把故障主节点的从节点自动提为主节点,原来的主节点恢复后,自动成为新主节点的从节点。
这里先说明,把一个master和它的全部slave描述为一个group,故障转移是以group为单位的,集群故障转移的方式跟sentinel的实现很类似。
均衡集群
在集群运行过程中,有的master的slave宕机,导致了该master成为孤儿master(orphaned masters),而有的master有很多slave。
此处孤儿master的定义是那些本来有slave,但是全部离线的master,对于那些原来就没有slave的master不能认为是孤儿master。
redis集群支持均衡slave功能,官方称为Replica migration,而我觉得均衡集群的slave更好理解该概念。集群能把某个slave较多的group上的slave迁移到那些孤儿master上,该功能通过cluster-migration-barrier参数配置,默认为1。
slave在每次定时任务都会检查是否需要迁移slave,即把自己变成孤儿master的slave。 满足以下条件,slave就会成为孤儿master的slave:
- 自己所在的
group是slave最多的group。 - 目前存在孤儿
master。 - 自己所在的
group的slave数目至少超过2个,只有自己一个的话迁移到其他group,自己原来的group的master又成了孤儿master。 - 自己所在的
group的slave数量大于cluster-migration-barrier配置。 - 与
group内的其他slave基于memcmp比较node id,自己的node id最小。这个可以防止多个slave并发复制孤儿master,从而原来的group失去过多的slave。
优势
- 去中心化,集群最大可增加1000个节点,性能随节点增加而线性扩展。
- 解耦 数据 和 节点 之间的关系,简化了节点 扩容 和 收缩 难度。
- 节点自身 维护槽的 映射关系,不需要 客户端 或者 代理服务 维护 槽分区元数据。
劣势
key批量操作 支持有限。类似mset、mget操作,目前只支持对具有相同slot值的key执行 批量操作。对于 映射为不同slot值的key由于执行mget、mget等操作可能存在于多个节点上,因此不被支持。- 只支持 多
key在 同一节点上 的 事务操作,当多个key分布在 不同 的节点上时 无法 使用事务功能。 key作为 数据分区 的最小粒度,不能将一个 大的键值 对象如hash、list等映射到 不同的节点。- 不支持多数据库空间,单机下的
Redis可以支持 16 个数据库(db0 ~ db15),集群模式下只能使用一个 数据库空间,即 db0。 - 复制结构 只支持一层,从节点 只能复制 主节点,不支持 嵌套树状复制 结构。
集群搭建
1 | #redis.conf相关集群配置 |
1 | #分别修改不同的redis.conf,注意,不同的redis.conf分开文件夹 |
1 | 查群脚本命令帮助文档 |
1 | 查看集群状态 |
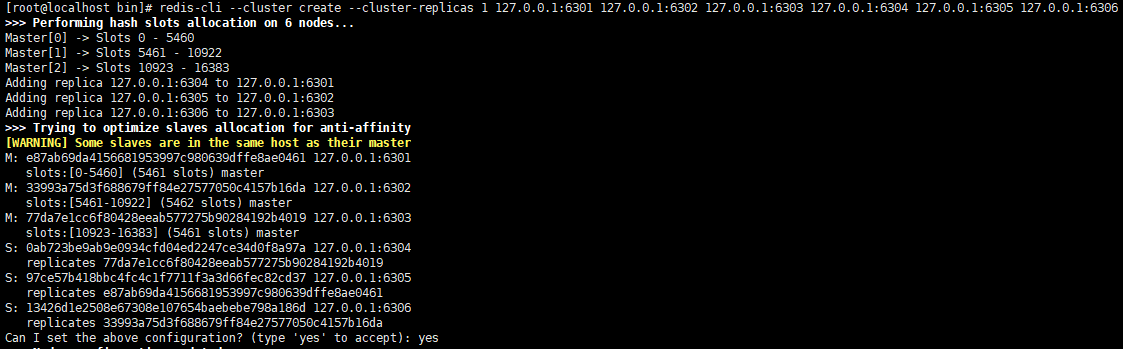
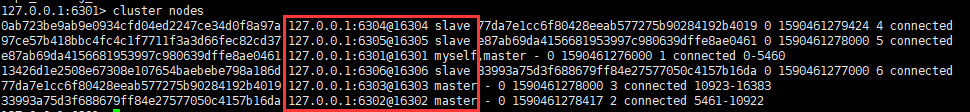
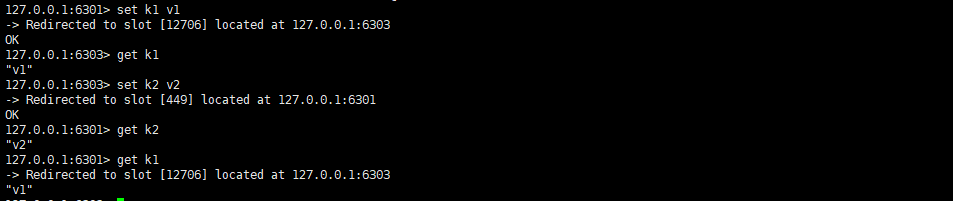
当访问的slot在当前机器时,直接返回,当数据在其他master管理的slot中时,会自动重定位到负责该slot的master机器
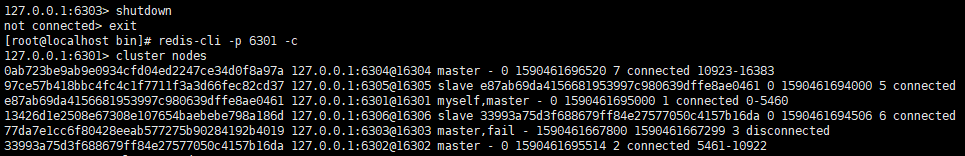
可以看到当我把6303端口的master停止后,6304端口的slave上位成master。
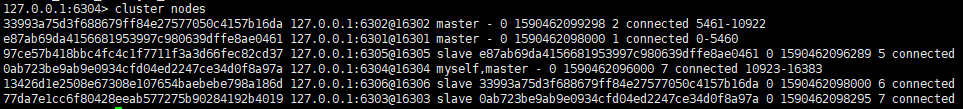
当我重启6303端口的redis时,6303端口的redis自动成为6304端口master的salve。
部分内容出自文章:
https://blog.csdn.net/wuxian90/article/details/81590252
https://www.cnblogs.com/pingyeaa/p/11294773.html
https://www.jianshu.com/p/84dbb25cc8dc
https://nealli.gitee.io/2020/05/21/Redis%E9%9B%86%E7%BE%A4%E5%AE%89%E8%A3%85/
最后更新: 2021年01月20日 23:58